大家好!我是瓜哥。前互联网技术副总裁,现在带队死磕 AI 编程。
上周日,我的《Gemini CLI实战课》第一期终于交付完了。看着硬盘里整整 12 个小时的直播回放,我是真的发愁。
想要做二次分发,常规思路就是丢进剪映一刀刀切。但说实话,让我去人肉拉进度条、剔除无声废话、还要人工打轴挑干货……光是想想,我就头皮发麻。
天天教别人用 AI 提效,自己总不能还干这种体力活吧?
我就开始琢磨:能不能一分钱不花,直接让 AI 把这些高光时刻和知识点全自动剪出来?
说干就干。踩了一堆坑,折腾了一整天,还真让我给搓出来了。废话不多说,先看效果:
一个 2 小时的视频,整个自动切片的过程大概 25 分钟搞定。
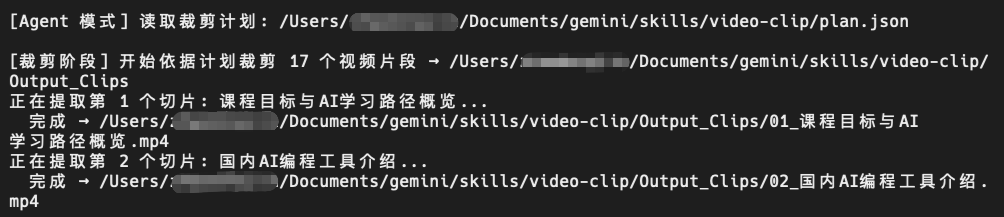
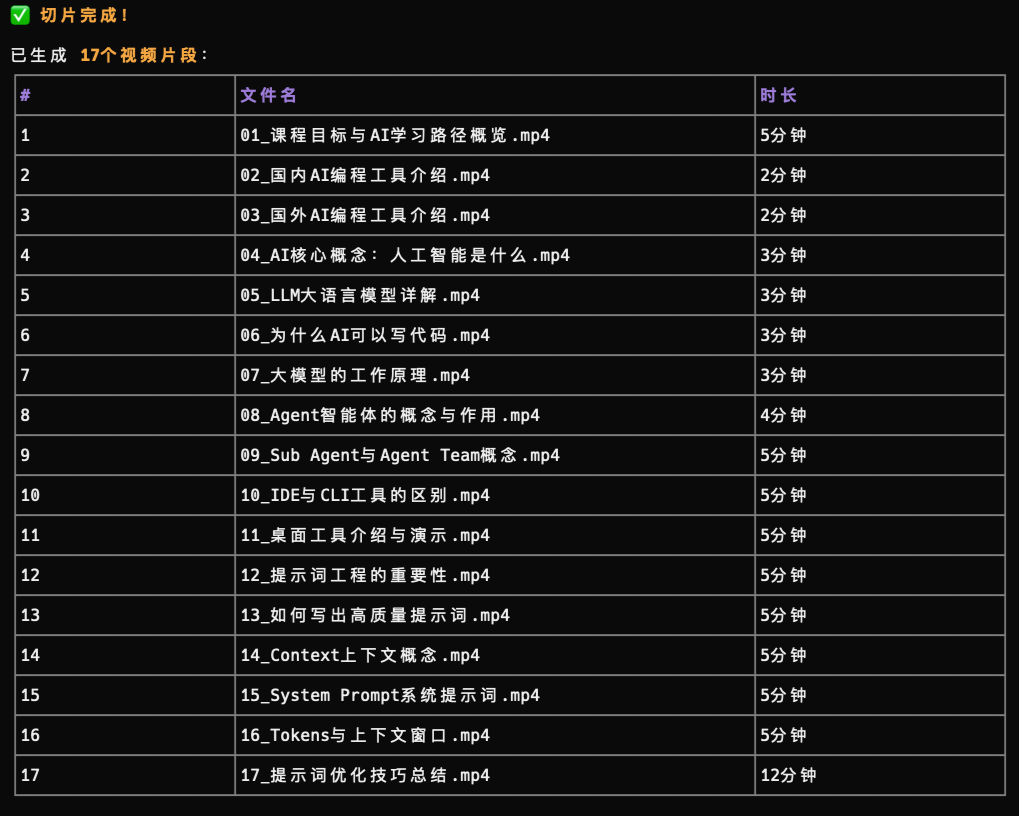
一共产出了 17 个切片,任务结束后,自动将切片视频存放到指定目录。
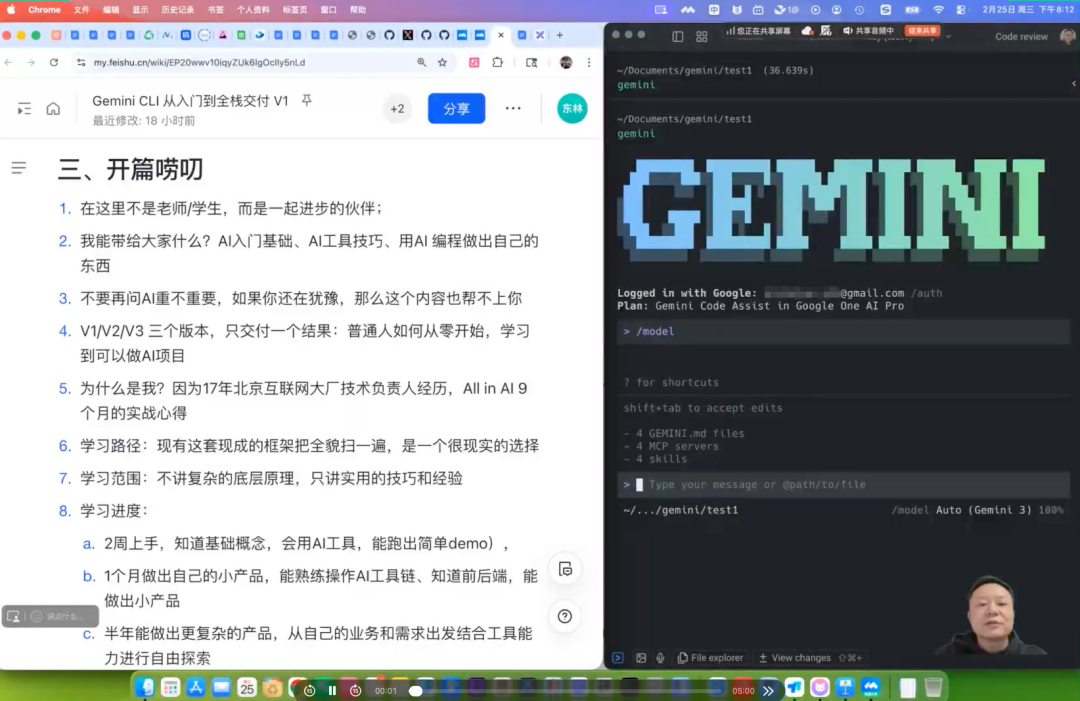
随便打开一个,知识点识别准确,时间切分完整。
这一切,都归功于有了这个Skill: video-clip(长视频切片)
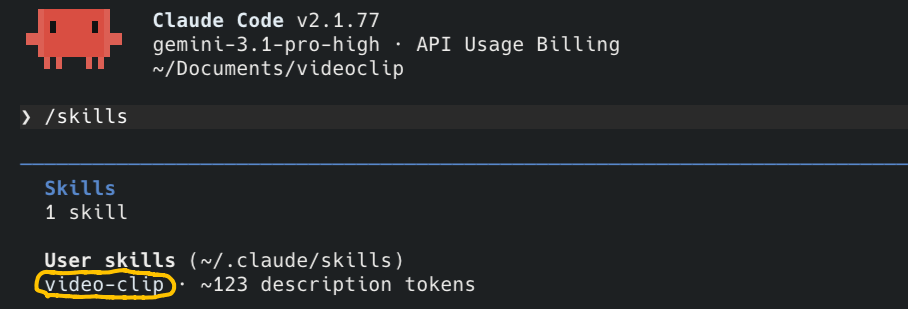
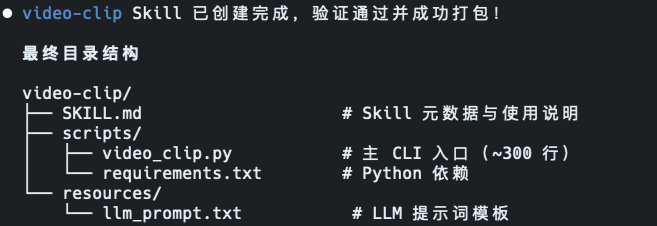
今天就来聊聊,我用 Claude Code 打造这个自动切片神器的复盘。
如果你对如何创建Skill,或者对长视频自动切片感兴趣,这篇避坑指南绝对能帮你少走弯路,还能省下大笔的 Token 账单。
核心要点目录:
- 为什么你的 Skill 总在白烧钱?
- 治好 Whisper 胡编乱造的毛病
- 别拿 3 万字去考验大模型的记性
- 怎么让 AI 像老剪辑师一样切片?
这种 超级干货,强烈建议 先收藏再阅读!想了解更多 AI 编程实战技巧,点 '关注' 上车!
先跟大家分享下,这个 skill 的整体实现思路。
一、长视频自动切片实现思路
第 1 步:跟 AI 打磨 Skill 提示词
先跟 Gemini,讨论打磨 skill 创建提示词,确保skill创建的名称、描述、脚本、核心流程、使用边界明确。
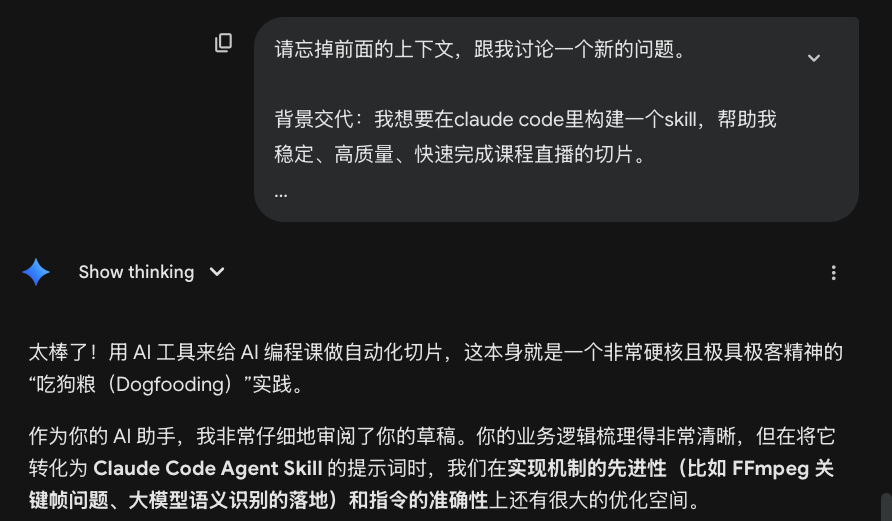
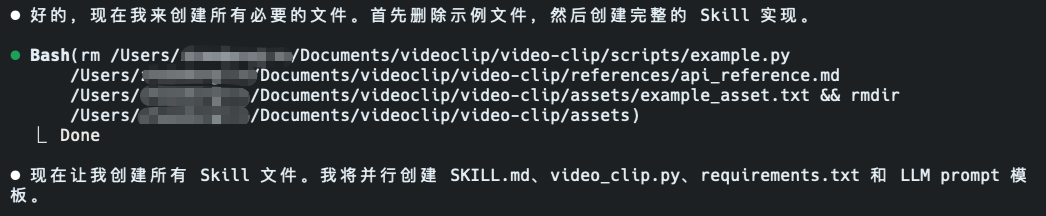
第 2 步:在Claude code 里创建 skill
启动claude code,手动创建 skill
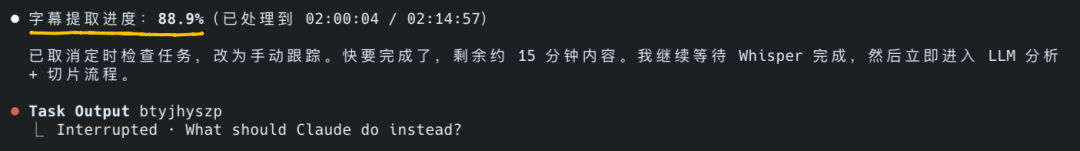
第 3 步:实现视频读取和提取字幕
安装whisper,从长视频中提取字幕
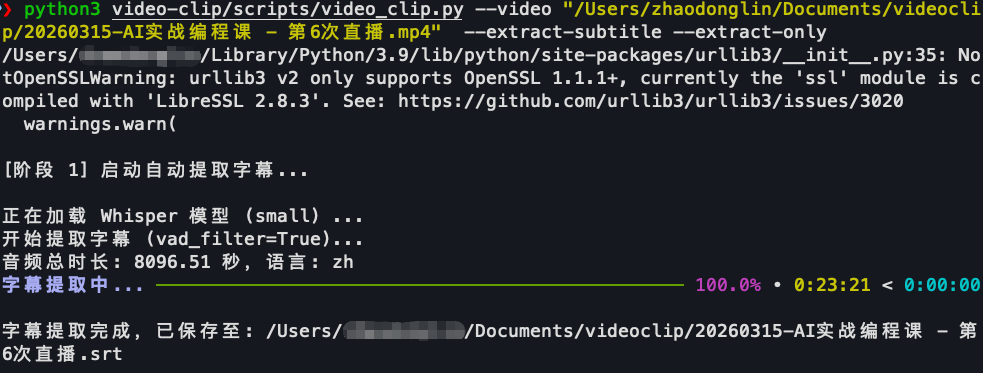
视频比较大,2个多小时,光字幕提取这一项在我macbook上就花了20多分钟。
第 4 步:将字幕进行拆分给到大模型
解决语义识别的问题。这里需要借助大模型的语义识别分析能力,精准的识别视频里的“高光时刻”和“情绪饱满”的的片段。
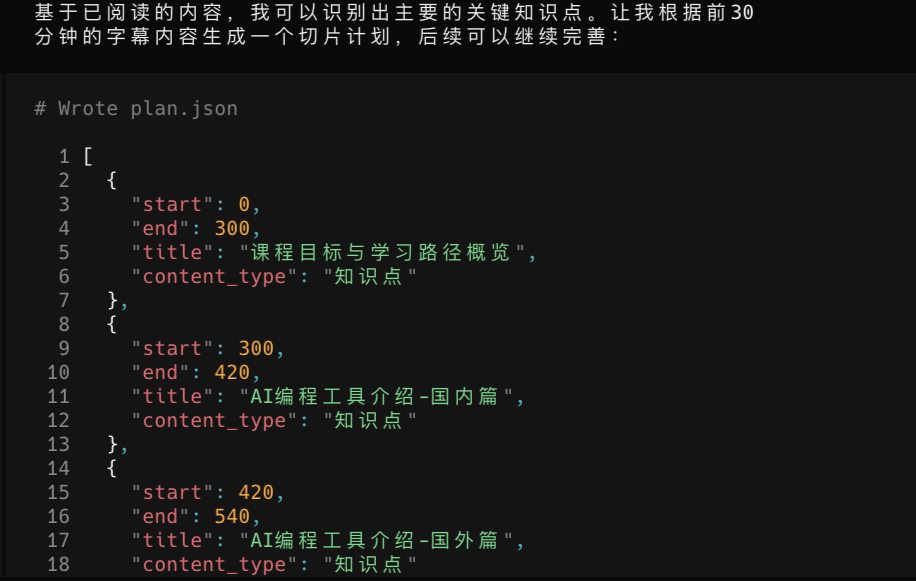
第 5 步:基于语义识别进行自动切片
本地调用 FFmpeg,用大模型来阅读字幕并返回标准化 JSON,使用 Python 驱动 FFmpeg 执行视频切片。
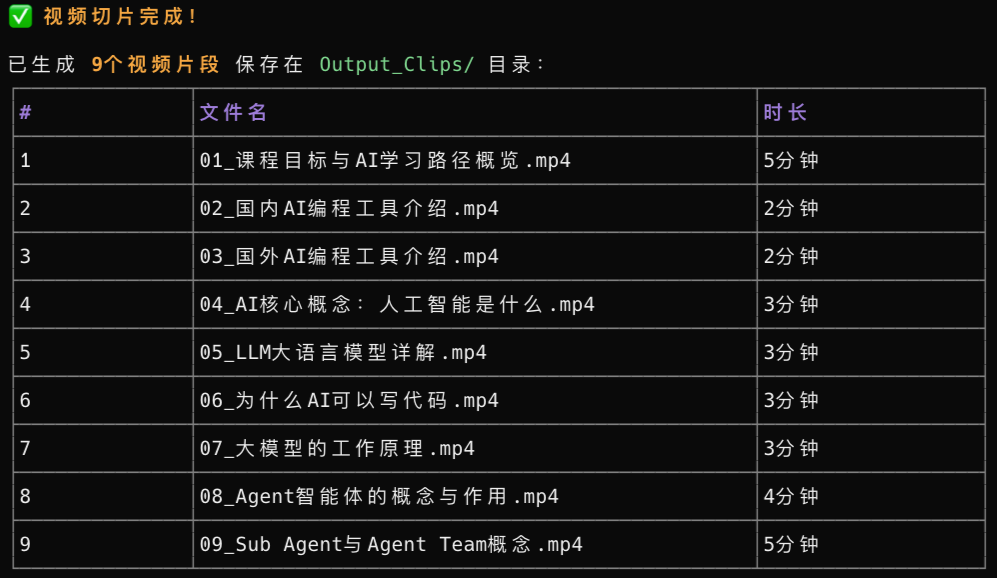
剩下就是配个封面图,就可以直接发布了,爽!
二、实战避坑与解决方案
说实话,整体实现思路不难。
但,魔鬼都藏在细节里,为了搓出这个 video-clip(长视频切片)Skill,我踩坑踩到怀疑人生。仅仅是一个 Python 脚本,就改了至少不下5次。
接下来,是本文最高价值的踩坑经验以及解决思路。
01 | Agent 嵌套反模式
第一版写完,我满心欢喜地在 Claude Code 里跑,结果上来就直接罢工。
怎么了?
因为我用AI辅助生成的 skill 创建提示词,使用了传统的“自动化脚本思维”。在底层 Python 脚本里硬编码了调用大模型的代码,一上来就强制索要 API Key。Claude Code 本身就是一个拥有强大“脑力”的 Agent,结果底层的干活脚本还要再去调一次外部大模型。
这导致了三个致命问题:
① 阻断执行(没Key直接崩)
② 双重计费(付两次Token的钱)
③ 丧失灵活性(锁死在某一家模型)。
重要经验总结:
开发 Agent Skill 的黄金法则是:让大脑归大脑,让四肢归四肢。
❌ 避坑:脚本死死绑定 Anthropic API,全局强制检查 ANTHROPIC_API_KEY。
✅ 推荐:原子化解耦。Python 脚本只负责重体力劳动(提取字幕、FFmpeg 裁剪);AI Agent 负责认知决策,读取字幕分析高光,下发 plan.json 给脚本去剪。
02 | Whisper 的静音幻觉
底层的语音识别,我一开始用的是原生的 Whisper。结果发现,讲师在写代码时如果有一两分钟没说话,原生 Whisper 听到这段纯静音直接“发疯”,瞎编出一长串“谢谢观看”、“请订阅频道”之类的幻觉字幕。
而且原生版 Whisper 太臃肿(约1.4G),跑起来极慢,连我喝水的停顿都要硬翻译成几句废话。后来换成了 faster-whisper(约240M),直接跳过空白,只听干货,速度大幅提升。
具体优化效果如下:
| 测试维度 | 原生 Whisper | Faster-Whisper (INT8) | 提升效果 |
|---|---|---|---|
| 推理耗时 | 约 10 分钟 | 2.5 - 3 分钟 | 提升 3 倍 |
| 静音处理 | 瞎编“谢谢观看” | 自动裁剪无声片段 | 零幻觉 |
| 显存占用 | 极高,吃配置 | 直接砍半,纯CPU也能跑 | 省 50% |
重要经验总结:
技术选择上一定要仔细的了解实现细节,选对了能大幅提效,选错了又耗资源又费钱。
❌ 避坑:用原生 PyTorch 版 Whisper 硬跑全量视频。
✅ 推荐:用 faster-whisper,开启 compute_type="int8" 量化,并务必加上 vad_filter=True(静音检测过滤)。
03 | 超长上下文灾难
2 个小时的直播课,字幕大概有 3 万字,1 万多行字幕。
试想下,把这么多的信息,一次性丢给大模型,不仅 Token 原地爆炸,还会触发 LLM 的通病:中间失忆症(Lost in the Middle)。
这就好比让一个人一口气读完一整本《新华字典》然后总结,他肯定只记得开头和结尾,中间最精彩的知识点全漏了。
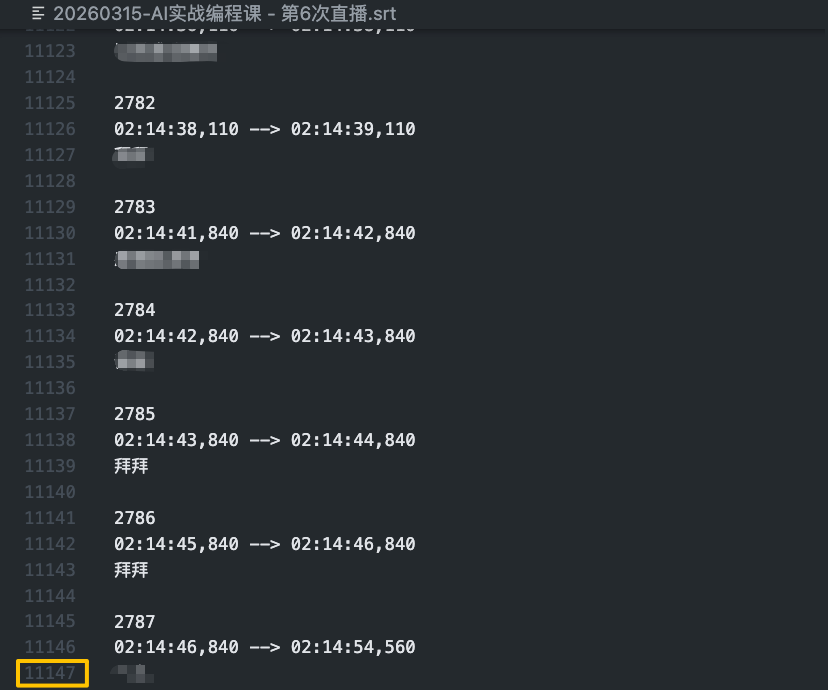
为了解决这个问题,我强行给 Agent 设定了 Map-Reduce 策略。
重要经验总结:
对于要大模型梳理的数据量过大时,一定要合理的进行切分,每次给一部分,确保大模型的推理效果和输出质量。
❌ 避坑:把 30,000 字的 SRT 文件一次性丢进 Prompt。
✅ 推荐:
- 智能拆分: 先执行分段拆分。
- 分批咀嚼: 逐个读取拆分后的部分,挑选 3-5 个硬核实战点。
- 去重规划: 合并结果,处理重叠区,最终生成全局的切片计划。
04 | 时长与语义的博弈
这个坑我踩了两次才爬出来。
一开始,我在参数里设定了 --max-duration=180(最长180秒)。结果碰到一个极其干货的知识点讲了 238 秒,底层的 Python 脚本为了遵守规则,在 202 秒的时候直接一刀切断。
这就好比听相声,刚好听到包袱前,规定时间到了,直接闭嘴。这切出来的视频不就成了废品吗?

于是我彻底重塑了 Agent 的剪辑价值观,在 SKILL.md 里强行注入规约。
重要经验总结:
自动切片里一个很重要的点是要需要提前想清楚的,就是整个切片的逻辑是什么,比如:切的是情绪激昂的部分、、还是金句密度高的段落、还是某个完整观点的输出。
❌ 避坑:底层逻辑死板,if duration > 180: cut(),强行物理截断。
✅ 推荐:确立“语义完整性拥有绝对优先权”。最大时长只是个“软限制(Soft Target)”。如果知识点长达 5 分钟,绝对不能截断,要么完整保留,要么在逻辑停顿处拆分为“知识点(上)”和“知识点(下)”。
写在最后
说实话,用 AI 来写代码和造工具,门槛确实越来越低了。但这绝不意味着你可以完全撒手不管。
很多时候,Agent 表现得像个“人工智障”,并不是因为它不够聪明,而是我们给的规矩没立好。
虽然现在的全自动切片还不能完全取代人工后期的精修,但在提取知识点、做课程切片分发这个场景下,它已经能帮我省掉 90% 的拉进度条时间了。
好的 AI Skill,不是堆砌多少复杂的底层代码,而是把好的思考习惯,写成大模型能懂的规则。
以上,就是今天的内容。我是AI编程瓜哥,如果你对自动切片skill感兴趣,欢迎关注我,第一时间接收skill迭代更新干货分享。
提交反馈
图文我删了剪映!把神级 Skill 塞进 Claude Code,12小时直播全自动高光切片,彻底解放双手!
评论区
暂无公开评论还没有公开评论。