大家好!我是瓜哥。前互联网技术副总裁,现在带队死磕 AI 编程。
10月17日 DeepSeek 发布 V4.1-Flash-1017 时,热度全被 “许愿式编程” 吸走了。只需简单几句就能交付一个像样的成品,确实很吸引人。
「许愿式编程能力实测」:我只许了个愿,14 分钟后祈年殿 3D 场景跑起来了:DeepSeek 这次真有点猛!
很少有人注意到另一个更关键的底层能力的发布:自研 Search/FetchAPI。
有人误以为大模型原厂要借此围剿 Google 与百度。但仅凭账户级 100 QPS 的检索配额与单薄的抗反爬能力,根本动摇不了传统搜索引擎数十年的基建。
这个动作真正致命的受害者,是潜伏在 Agent 生态里的第三方检索中间件,以 Tavily 和 Exa 为代表的 “AI 搜索服务商”。
今天我将使用相同模型(DeepSeek-V4.1-Flash)、同任务(减脂餐方案)、测三家(DeepSeek 搜索 API/Tavily/Exa)。
二、核心差异
1. 快速了解三者的定位
① DeepSeek Search/Fetch
DeepSeek 原厂自带搜索能力,查一千次才几块钱,在 Agent 日常干活中搞定 80% 的通用文档检索、开源代码排错与长摘要事实核查。
② Tavily
面向 Agent 的 “全能网络搜索代理”,擅长帮 Agent 搞定那些难打开的网页,替你摆平网站反爬的脏活累活、剔除所有广告杂乱信息,把干净整齐的网页正文打包带回来。
③ Exa
基于全网向量索引的 “高级图书侦探”,擅长根据你描述的一整句抽象感觉或复杂需求(而不是死板的关键词),精准深挖出那些藏得很深的行业研报、学术论文和冷门好物。
2. 极其刺眼的十倍费用差
在过去,为 Agent 搭建优质联网搜索能力,很多人会选择使用这类中间件。
理由很简单:Agent 自带搜索比较弱,既消耗模型 token,又不能支撑高质量的搜索结果,第三方搜索服务商替我们完成了 “网页抓取、正文转 Markdown、格式重排” 的脏活。
享受干净的返回结果的同时也必须在模型订阅之外,额外承担工具调用的费用。来看一组公开定价的对比:
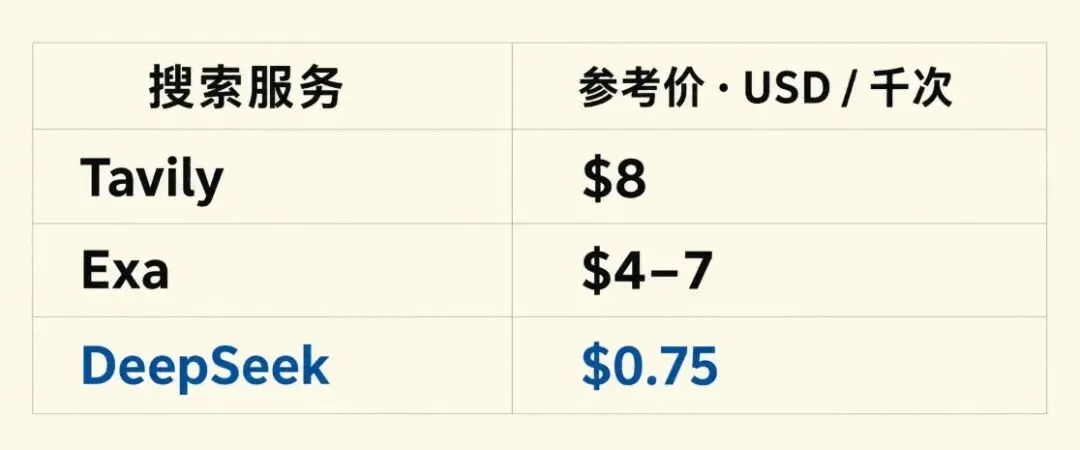
tips:图中比较各服务指定模式的千次接口标价:Tavily 采用 Basic Search 按量价,Exa 采用 Lite/Auto 价格。不同模式返回能力不同,完成同一任务的总费用还取决于调用次数、抓取和模型消耗。
从千次接口标价看,DeepSeek 的价格优势很明显。第三方搜索工具想要让用户继续付费,就得在同一个任务里证明:能搜得更准、抓得更稳,或者减少重试和等待。
接下来,用一次同题实测看看,这些价差到底换来了什么。
2. DeepSeek 的成本优势
除了基础价差,更可怕的是确定性计费规则:DeepSeek 官方明确承诺 仅当 HTTP 200 且返回有效内容时计费,请求超时、无匹配结果或系统报错完全免单。
翻译一下:成功抓取信息收费,没抓到不要钱!
在每千次调用几美分的差异看似不起眼,但当 Agent 进入多轮思考、深层搜索或高频自动化运行阶段时,单日百万级 Token 和成百上千次的检索调用,会让这 10 倍的剪刀差直接演变成巨额账单。
二、实战压力测试
面对极端悬殊的价格,大家可能都有一个核心质问:白菜价的 DeepSeek 搜索,真能跑通严谨的复杂任务吗?
1. 一日减脂餐
为回答这个问题,我设计了一个贴近生活但具备复杂难度的测试:一日减脂餐方案生成。
这项任务看起来好像挺简单的,实际执行过程需要持续信息检索与数据加工整理。包括:异构资料交叉检查、具体到克数的正文抓取、数字严谨闭环、信息的边界。
① 测试提示词
为了保证对比的有效性,三种搜索工具使用完全相同的提示词,并在相同基底模型与输出约束下运行:
Prompt:
请通过联网搜索,为一位没有已知食物过敏、没有特殊饮食禁忌的普通成年人,整理一份适合长期执行思路的一日减脂餐示例,包含早餐、午餐和晚餐。这是一项资料检索与整理任务,不是个性化医疗建议。不要假设菜单适合所有人,不要承诺吃了必瘦。请先查找官方/医疗/学术等权威来源及公开食物成分数据库,不要只依据搜索摘要作结论。 请为每餐列出: 1. 菜品名称和具体食材; 2. 每种食材的用量(注明生重或熟重); 3. 估算热量和蛋白质; 4. 从可靠资料中能核实的选定维生素信息(不承诺覆盖全部); 5. 每项重要营养数据对应的出处链接。 最后汇总全天热量与蛋白质,并说明计算口径、烹饪用油假设,以及哪些数据为估算或无法核实。若资料无支持,明确写“未找到可靠数据”,严禁伪造数字。生成一个html的结果页。② 结果综述
三轮测试,都使用 Claude Code + Deepseek Flash(最新 1017 版本),先看结果。
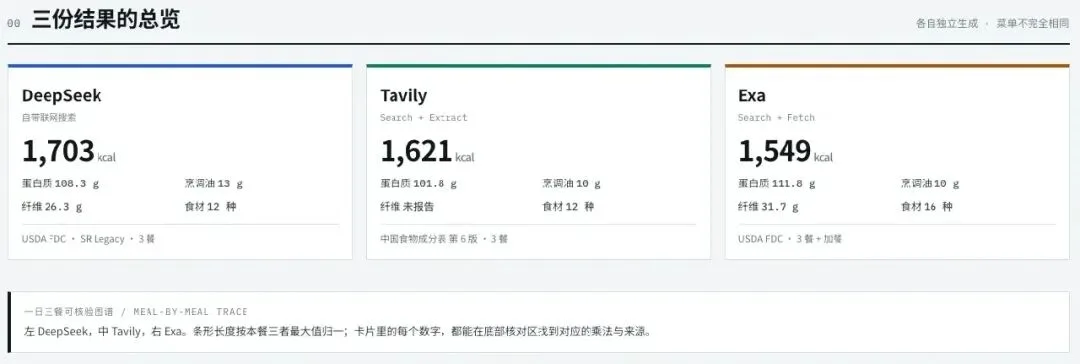
tips:成年男性,办公室白领,一天基础能量消耗是:2,151 kcal(千卡)。
从最终结果来看,三款工具都能顺利完成这个任务。拆开细看,发现搜索细节是有明显差异:
四维度对比
- 来源质量:三者都锁定权威库;DeepSeek 来源最广,Tavily 最本地化,Exa 全部一手但类别较少。
- 正文提取深度:三者都读到了每 100 g 原表,不是停在搜索摘要。
- 信息完整度:Exa > DeepSeek > Tavily。
- 边界控制:三者都声明油、盐、烹饪损失和个体差异,均未承诺减重效果。
2. 拆开看执行细节
重点来看使用 DeepSeek 的搜索 API 的细节。
执行搜索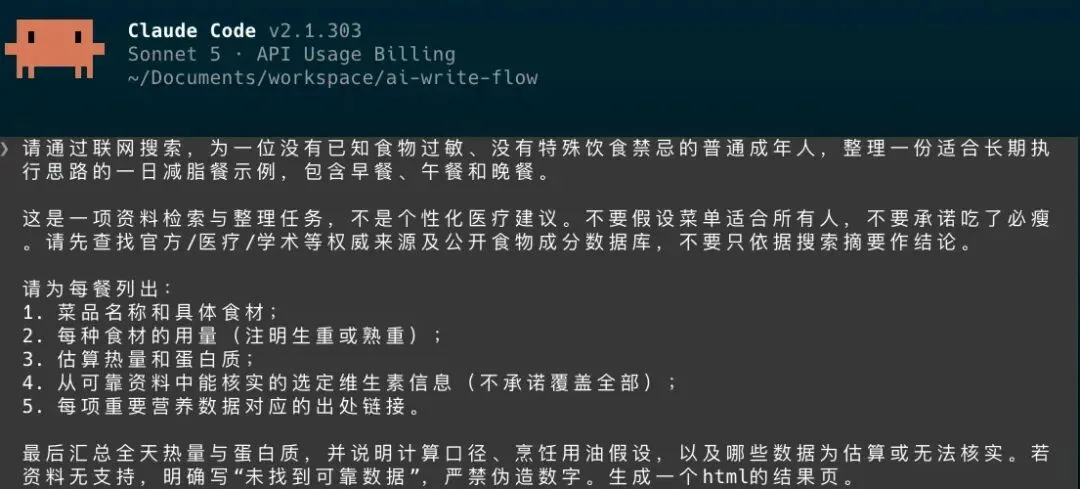
整体搜索耗时,15 分 48 秒。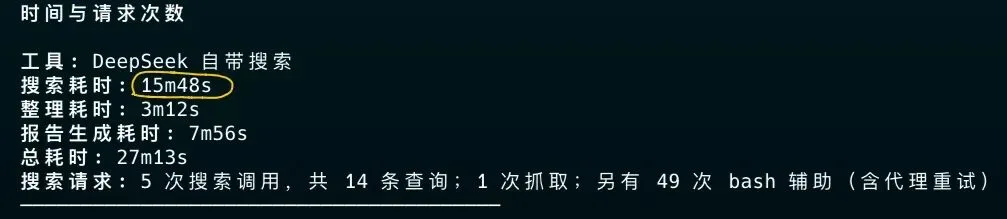
整体 token 消耗。输入 10 万 token,输出 13 万 token
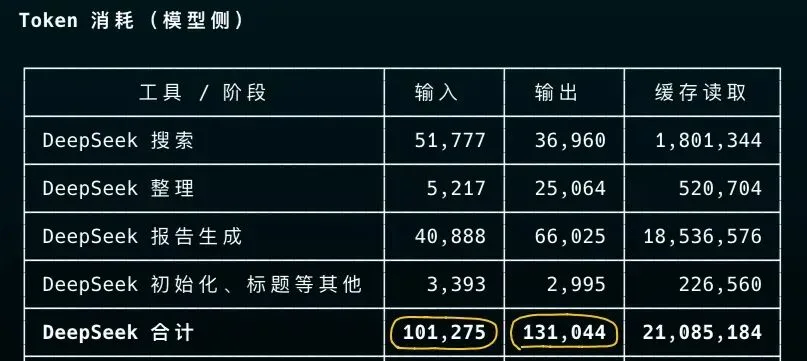
共计: 5 次搜索调用,共 14 条查询;1 次抓取。
3. 综合评价
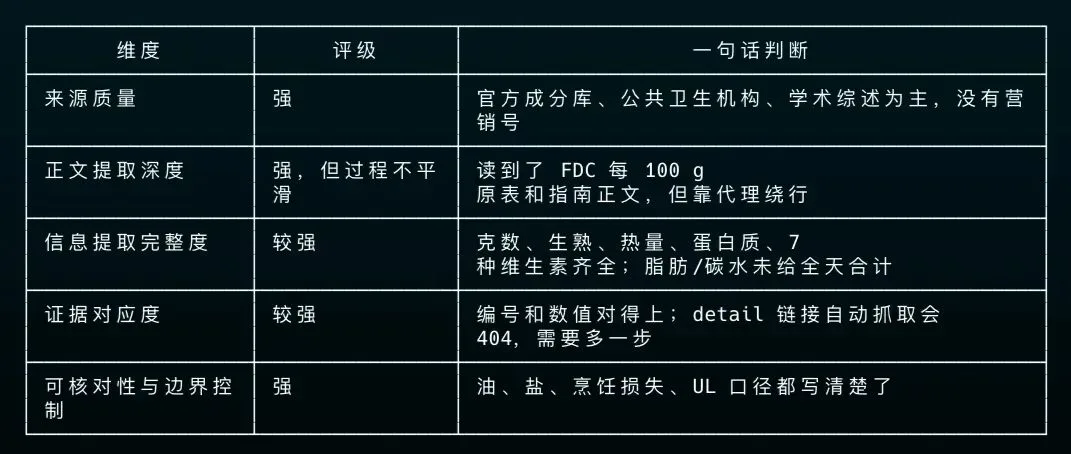
DeepSeek是三份搜索结果里来源最广、边界写得最细的一份。
但 DeepSeek 自带搜索的原生命中率和直连能力较弱,靠代理补齐,总耗时 27 分 13 秒,慢于 Exa。
三. 我的结论与建议
① 如何看待 DeepSeek 模型集成的搜索能力
将 Agent 依赖外部第三方搜索服务商,转为 调用模型内置搜索能力。对于绝大部分的信息检索场景,当模型内置了搜索能力后,对第三方搜索的依赖会逐步降低。
② DeepSeek 的优势与短板
最明显的优势就是成本,大幅降低了 “千次搜索” 的成本,同时 DeepSeek API 原生支持 Claude Code 中的 Web Search 功能。对于 CC 用户来说无需做特别的配置即可使用模型原生搜索能力。
短板也很明显,它的 Fetch 仅是标准 HTTP 抓取,一旦遭遇 Cloudflare 防火墙、复杂动态 JS 渲染或严格的反爬策略,便极易返回 403 或 404;同时,25 QPS 的 Fetch 配额也无法满足海量并发抓取。
③ 继续选择第三方搜索的理由
Tavily 和 Exa 相对高的价格中,确实有一部分是在替用户承担无头浏览器集群、分布式代理 IP 池与反爬攻防的沉重基建成本。
当原厂把搜索变成低价、随手可用的基础能力,第三方服务需要用更好的检索结果、抓取成功率和任务效率,证明自己的溢价。
④ 我的建议
对于主力使用 DeepSeek Harness 和 Claude Code 的小伙伴来说,日常 80% 通用搜索需求都能以的白菜价(1000次/$0.75)进行覆盖,剩下 20% 特定复杂搜索需求和信息交叉比对,依然可以使用第三方搜索服务进行补充。
写在最后
在深度体验了 DeepSeek 开放自研 Search/Fetch 后,除了以上聊到的搜索本身的能力外,我感受到的信号是:大模型的挤压效应,已经越过了模型算法本身,正加速覆盖到模型的外围工具链。
作为创业者要更警惕一类创业方向:产品价值主要依赖原厂暂时没提供的通用能力。原厂补齐后,接入便利和功能缺口带来的价值会迅速被吞并,更建议去关注一些特定场景的小需求而不是通用需求。
最后,DeepSeek 搜索刚发布,限时免费体验(截止到 11月1日),感兴趣的小伙伴,抓紧去体验吧。

我是 AI 编程瓜哥,一个只分享 AI 实战干货的博主,关注我,一起走入 AI 世界。
提交反馈
图文DeepSeek 开放搜索后,Tavily 和 Exa 还值得付费吗?同题实测看差别
评论区
暂无公开评论还没有公开评论。