帮一家电商企业定制的系统,图书蓝海词监控系统。
通过对电商平台图书这个品类进行自动监控,将原本每天运营人员需要投入2小时左右的筛选、整理、比较、确定选品的手工工作,降低为每天20分钟。
它可以自动化推荐 SKU 选品,甚至连商品标题和营销文案都一并自动生成了,极其省心。
一、项目背景
面向图书类电商运营的内部选品工具。图书电商的核心痛点是"选品靠经验、铺货靠感觉":面对商智后台导出的海量关键词和批发商甩来的杂乱书单,运营很难快速判断"哪个词值得抢、哪本书值得进货"。
二、目标
聚焦一个矛盾——选品确定性:先把"卖什么、手里的货值不值得卖"用数据算准。
三、核心实现
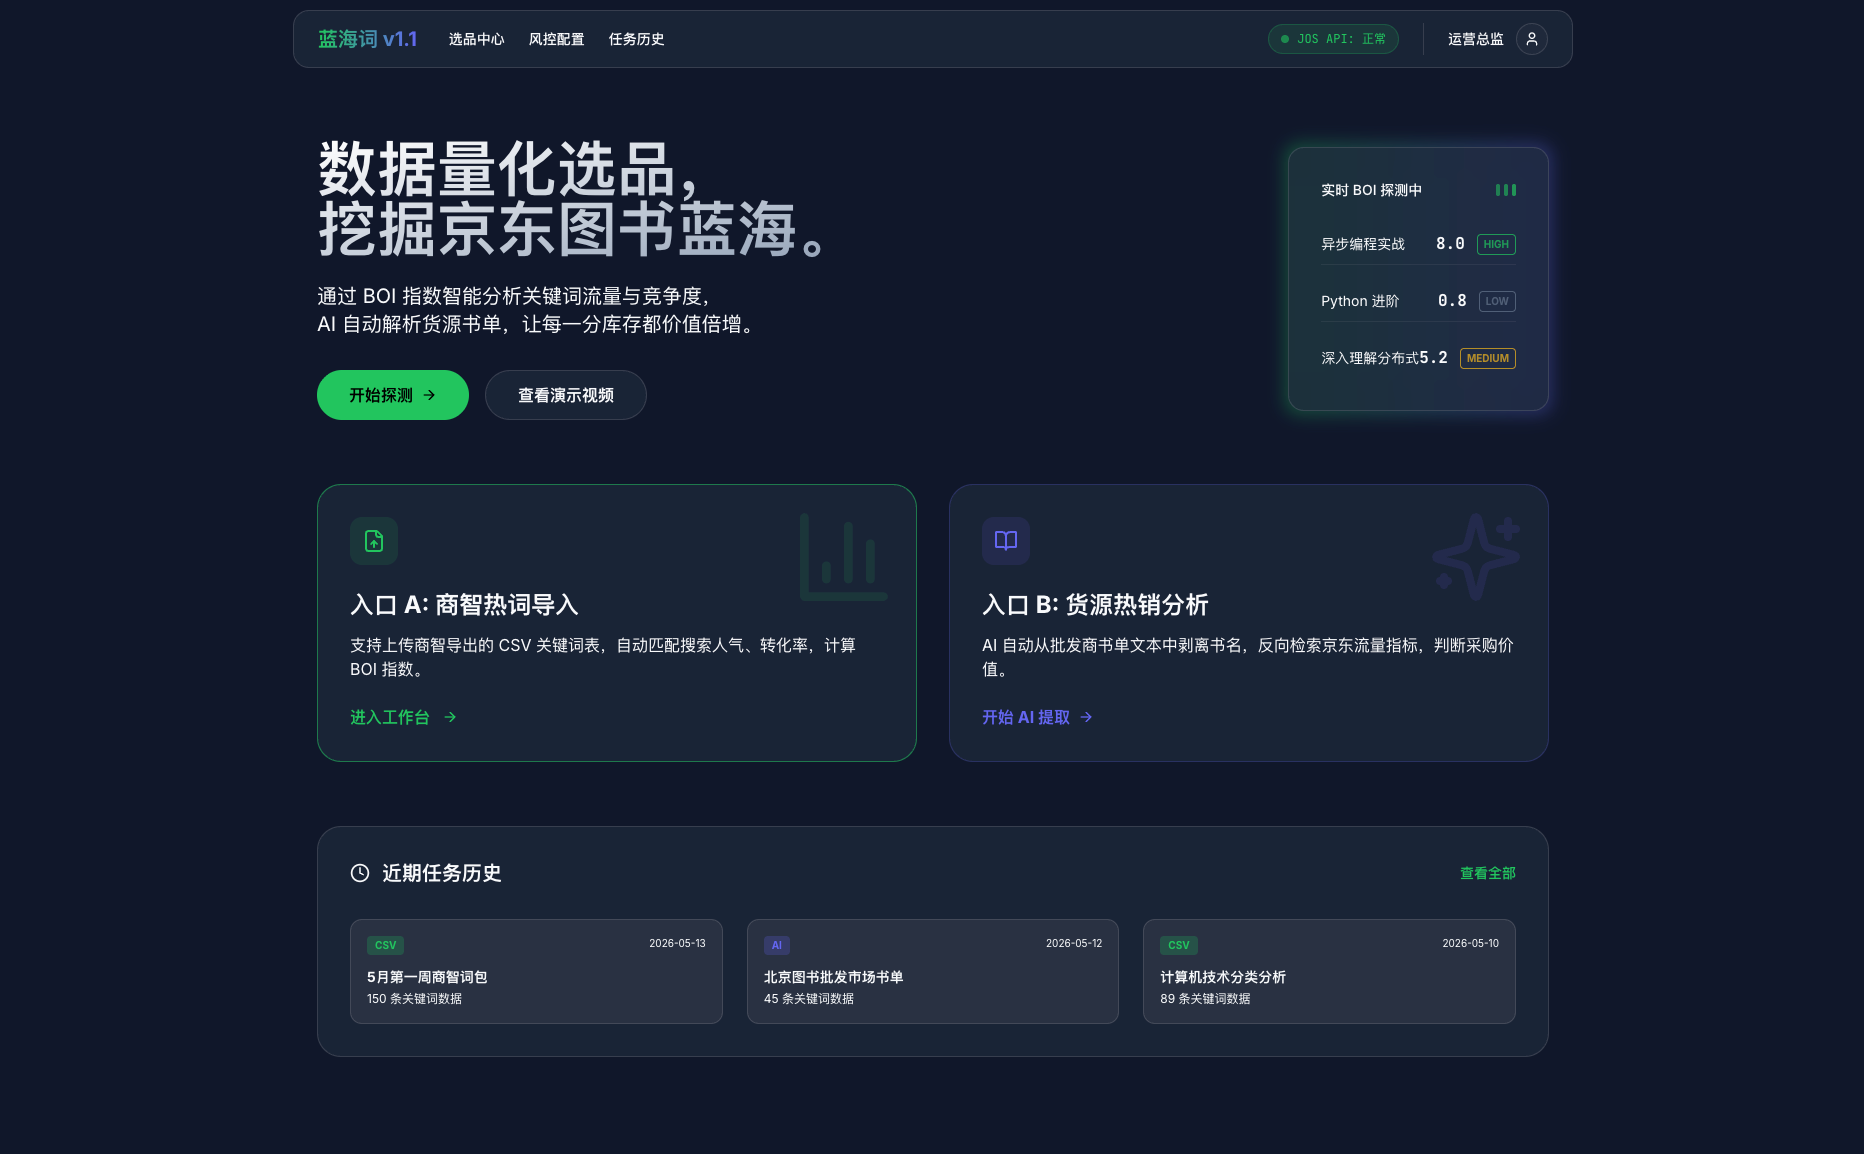
项目用一个量化指标把这件事标准化——BOI(Book Online Interest,图书线上热度指数):
▎ BOI =(搜索人气 × 预期转化率)/(在线商品数 × 自营系数)
分子是需求侧(有多少人搜、搜了买不买),分母是供给侧(多少家在卖、自营占多强)。BOI 越高 = 需求旺、竞争小,即"蓝海"。它本质上是把 RICE 评分、供需比这类成熟决策模型,落到了图书选品这个具体场景。
四、技术与功能
技术栈是现代、轻量的一线组合:Next.js 14(App Router)+ TypeScript + Tailwind CSS + Prisma + SQLite,深色玻璃拟态(Glassmorphism)数据看板风格。
产品围绕两个真实工作流入口设计:
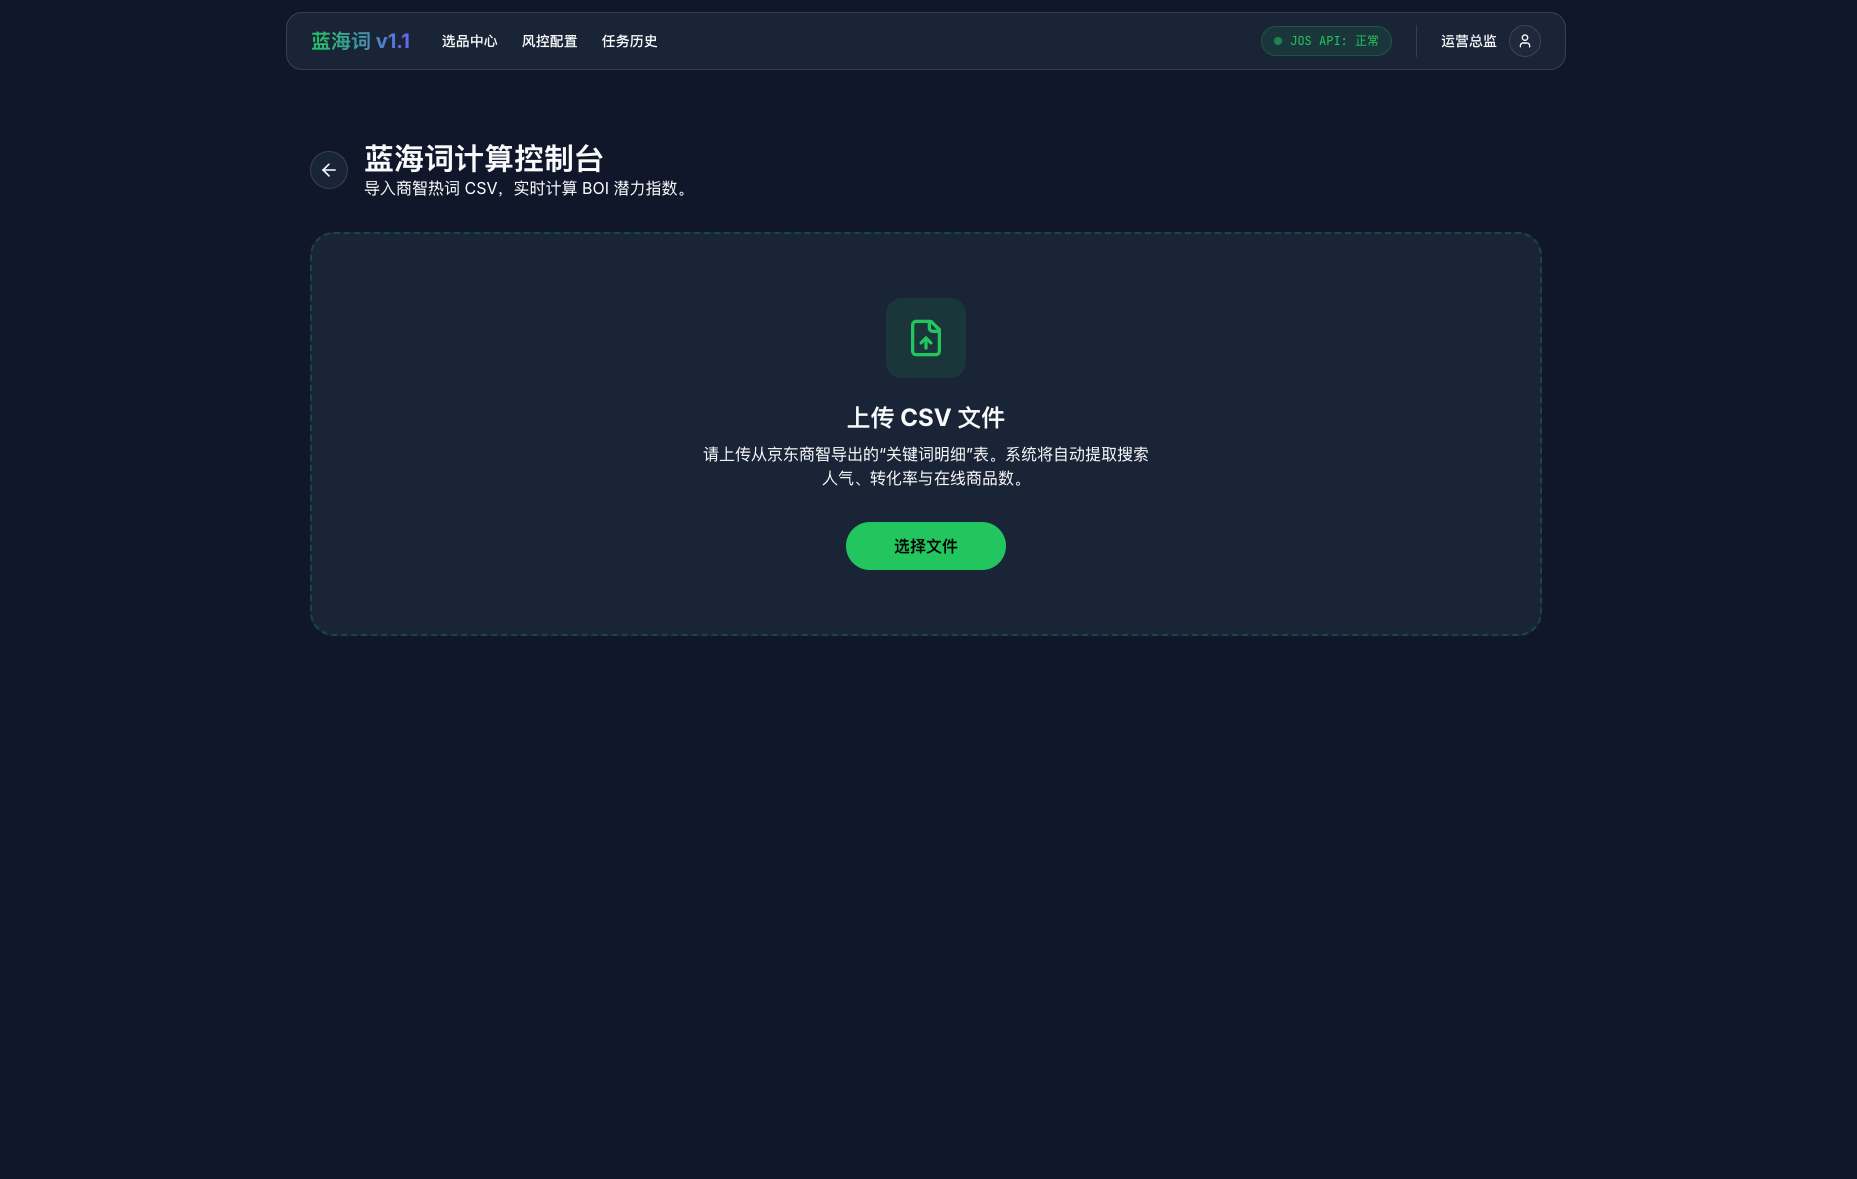
- 入口 A · 商智热词导入(蓝海词计算控制台):上传导出的关键词 CSV,前端解析(papaparse),自动处理"50.0 ~ 100.0"这类区间字段(取最大值、人气取整、转化率转百分比),按 BOI 排序落库。数据通过 Server Actions 写入 SQLite,带分片入库进度条、关键词去重 upsert、30 天陈旧数据自动清理。
- 入口 B · 货源热销分析(AI 书单解析):粘贴批发商书单(TXT/PDF/Excel 复制的杂乱文本),由 AI 剥离"(含碟)""2026版""出版社名"等噪音、还原核心书名,再反向回填京东流量指标,输出"建议采购 / 观望 / 放弃"。
数据模型(Prisma)已覆盖关键词批次、关键词条目、图书分析三张表,并预留了从 SQLite 迁移到 MySQL 的生产扩容路径。
五、部分产品 Demo 截图
由于商业保密要求,仅分享思路和部分 Demo 截图。
产品首页
兼容手动导入
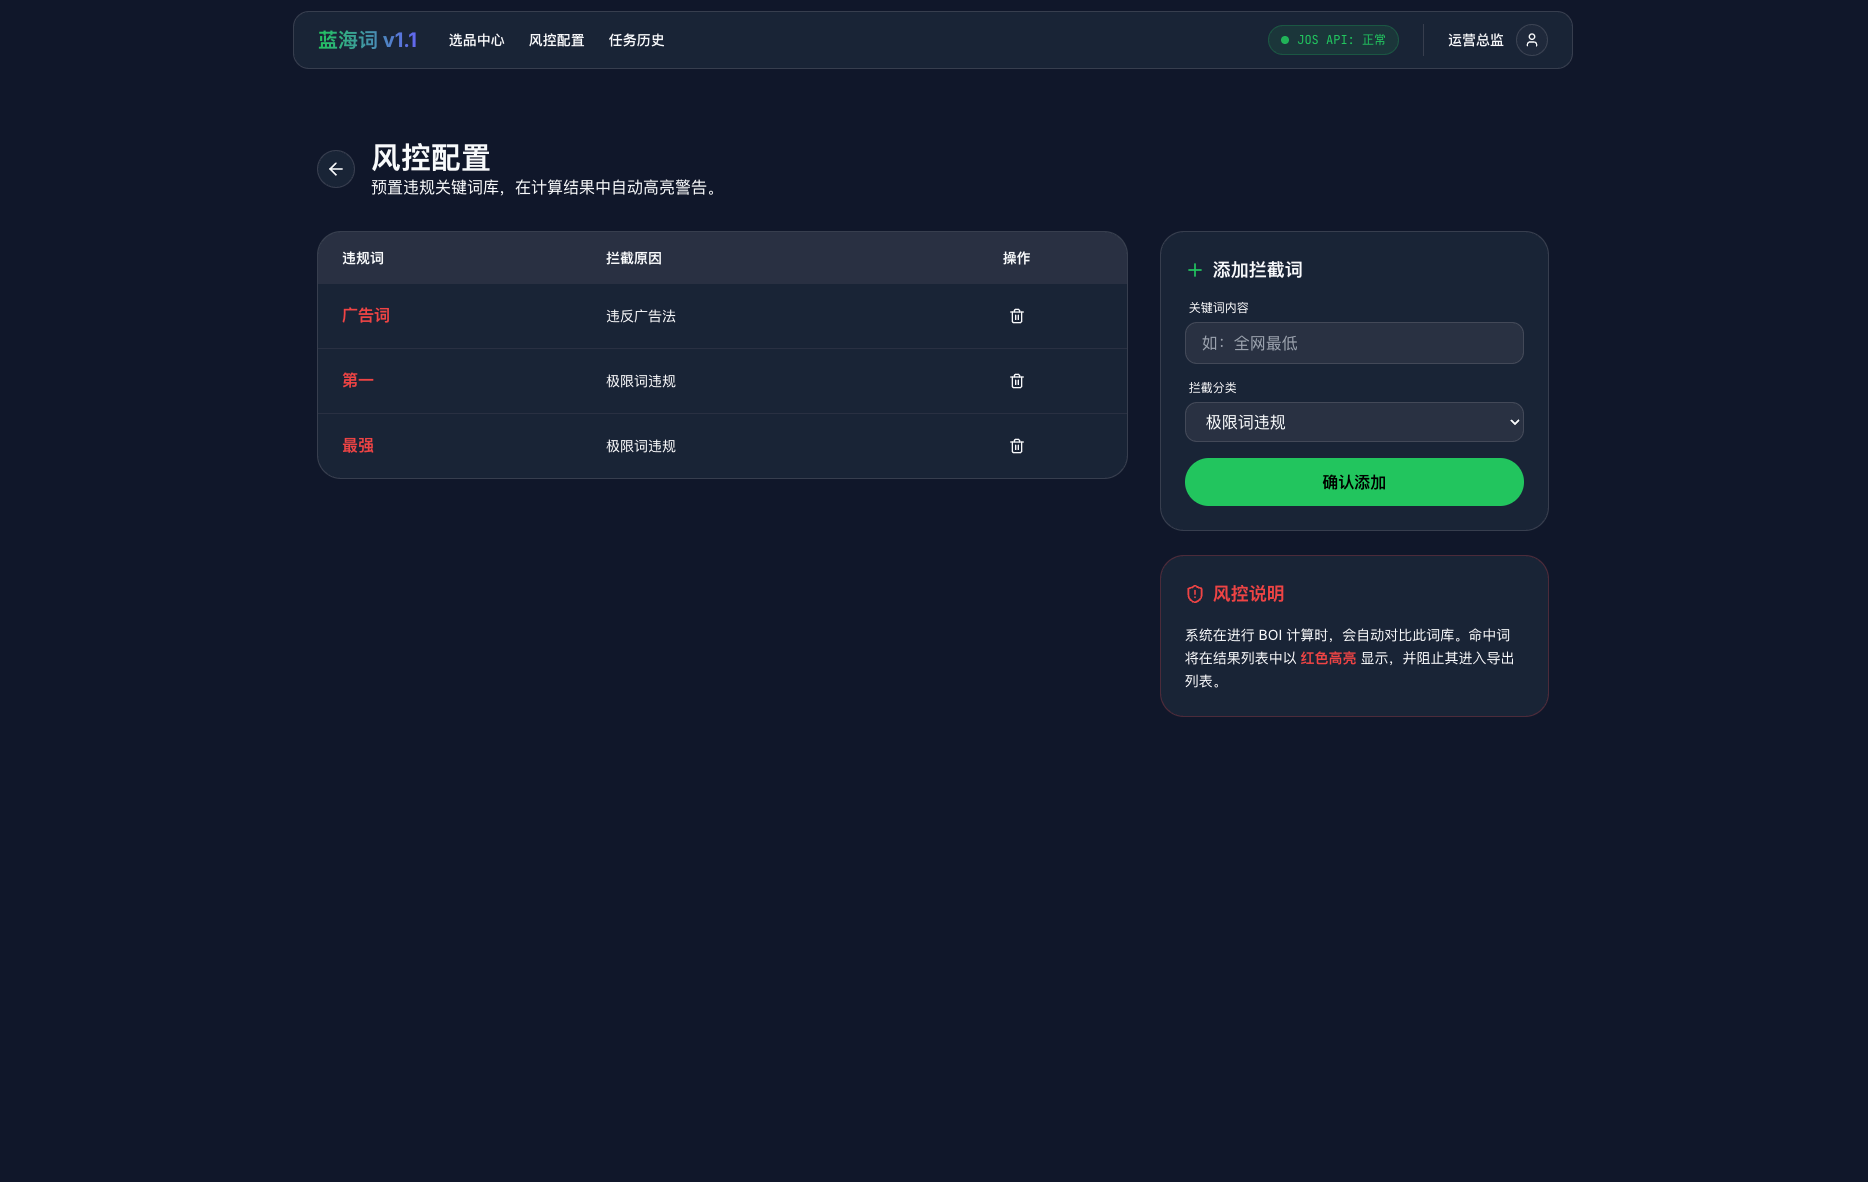
可配置的风控列表
提交反馈
图文电商行业-图书蓝海词监控系统
评论区
暂无公开评论还没有公开评论。