大家好!我是瓜哥,前互联网技术总监,现在AI编程这条路上持续探索和分享。
AI圈的迭代速度,已经不是按周,而是按天计算了。谷歌 Gemini 3 Pro 的‘最强’体验卡才领了不到一周,Anthropic 今早就扔了一颗核弹。
Claude Opus 4.5,来了。
就在刚刚(11月25日),Anthropic 不讲武德地放出了他们憋了三个月的大招。官方直接摊牌:"这是世界上最好的编码、智能体和计算机操作模型。"
这话听着狂,但看完数据,我只能说:神仙打架,凡人看戏。
01|代码能力:这一次,真的是"封神"
废话不多说,直接上最硬的菜。
在编程领域最权威的 SWE-bench Verified 基准测试上,Opus 4.5 直接轰出了 80.9% 的高分。
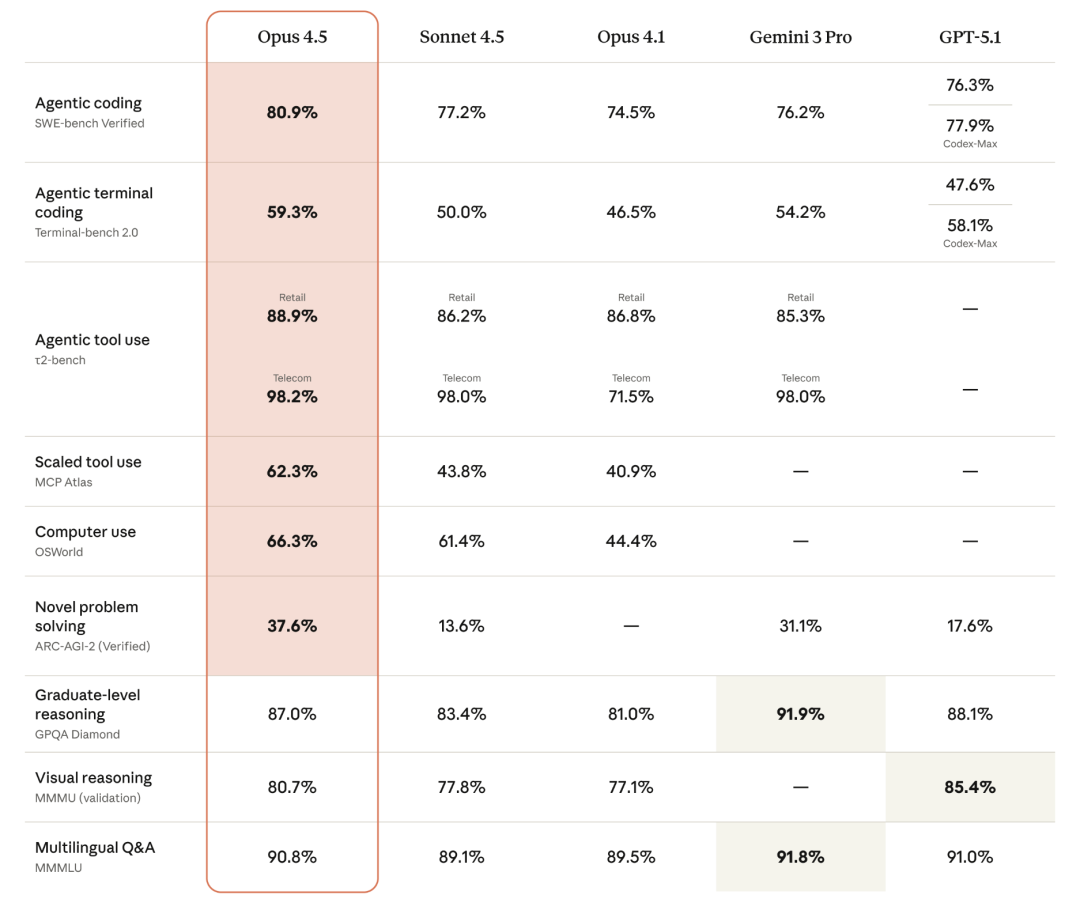
这是什么概念?
看看隔壁友商:
OpenAI的GPT-5.1-Codex-Max:77.9%
Google的Gemini 3 Pro:76.2%
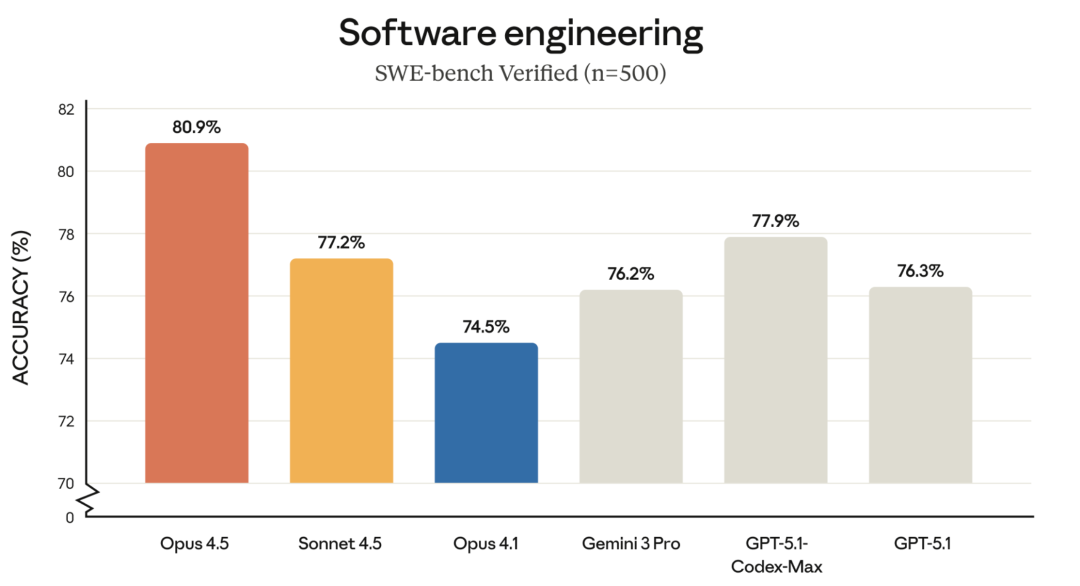
别小看这 3% 的差距。在高端代码局,基础题大家都会做,但遇到竞赛压轴题,Opus 4.5能拿满分,其他的只能干瞪眼。
更离谱的一个细节是:Anthropic 透露,在自家的内部高难度招聘笔试中,Opus 4.5 在规定时间内的得分,超过了所有人类候选人。
是的,你没听错,是所有。想想有点可怕...
02|价格膝盖斩:感谢 国产大模型?
这可能是 Opus 4.5 最让开发者兴奋(也最让友商头大)的地方:价格。
众所周知,Claude 的 Opus 系列一直是"贵族模型"——强是强,但用起来肉疼。
这次,Anthropic 似乎突然"开窍"了(也许是感受到了来自东方的神秘力量?)。
新的定价策略直接"膝盖斩":
- 输入:$5 / 百万
tokens
- 输出:$25 / 百万
tokens
对比上一代 Opus 4.1(输入 输出75),价格直接砍掉了三分之二!
这意味着,我们终于可以用 "白菜价" 享受到顶级的 AI 大脑了。对于企业用户来说,这几乎是把"雇佣 AI 员工"的门槛直接踩碎了。
03|安全方面向前迈进了一步
跑分只是数字,Opus 4.5 这次真正有价值的地方在于安全性的提升。
Opus 4.5 通过足够的训练以及大量的 “实战经验” ,大幅升级代码安全性,重点针对‘注入攻击’。
无论攻击指令藏得再深,想诱导大模型干坏事都没那么容易。
据官方介绍,在这个领域,Opus 4.5 可以说是目前业内最难被欺骗的模型。
当前最终表现如何,还得看广大用户实测的结果。
04|无限续杯:聊不到尽头
经常用 Claude 的朋友肯定懂那种痛:聊代码聊得正嗨,突然蹦出一句"上下文已达上限",瞬间心态崩了。
ClaudeAPI 中新增的“努力值”参数,可选择最大限度地减少时间和成本,或最大限度地提升功能。
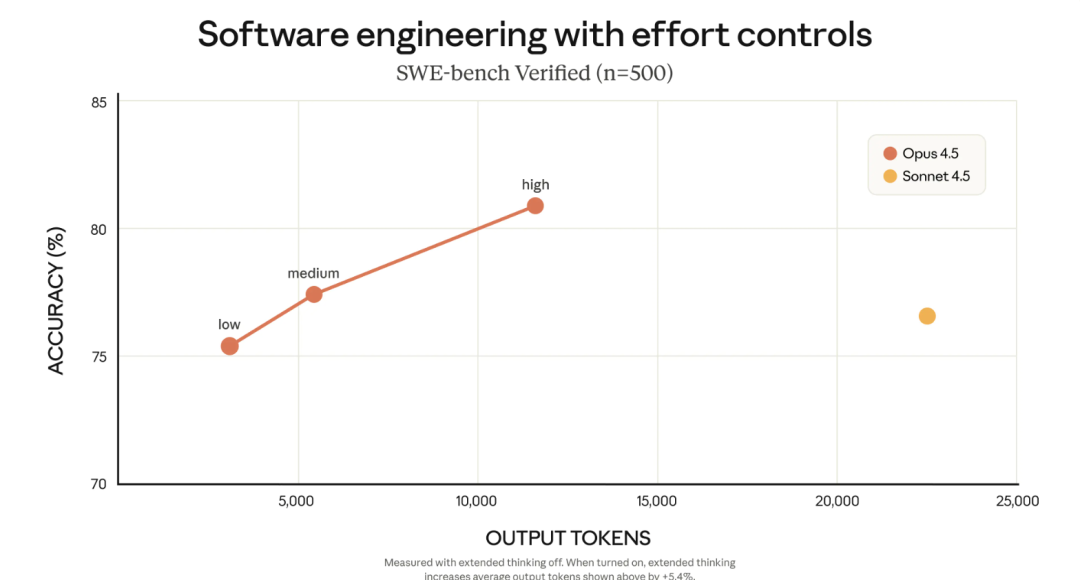
Opus 4.5 终于带来了救星功能:Context Compaction(上下文压缩)。
简单说,当对话变长时,系统会自动智能压缩前面的内容。这意味着你可以和它进行无限对话,无论是跑几十个小时的长程任务,还是讨论一个巨复杂的项目,再也不用担心它"断片"了。
写在最后
这一周的 AI 圈,简直比美剧还精彩。
前两天,大家还在为 Gemini 3 Pro 的手搓代码惊叹,今天 Claude Opus 4.5 就再次刷新了认知上限。
对于我们普通用户来说,巨头们卷得越凶,我们手里的工具就越强,价格还越便宜。
Opus 4.5 现已在 Claude.ai 和各大云平台上线。虽然它很强,但还是要提醒一句:Claude 封号依旧很凶,建议大家通过 Cursor 等第三方工具体验。
提交反馈
图文Claude Opus 4.5 突然发布,新模型价格暴降66%,代码能力全球第一?
评论区
暂无公开评论还没有公开评论。