大家好!我是专注分享AI编程实践的瓜哥。帮你轻松掌握AI编程核心技巧!
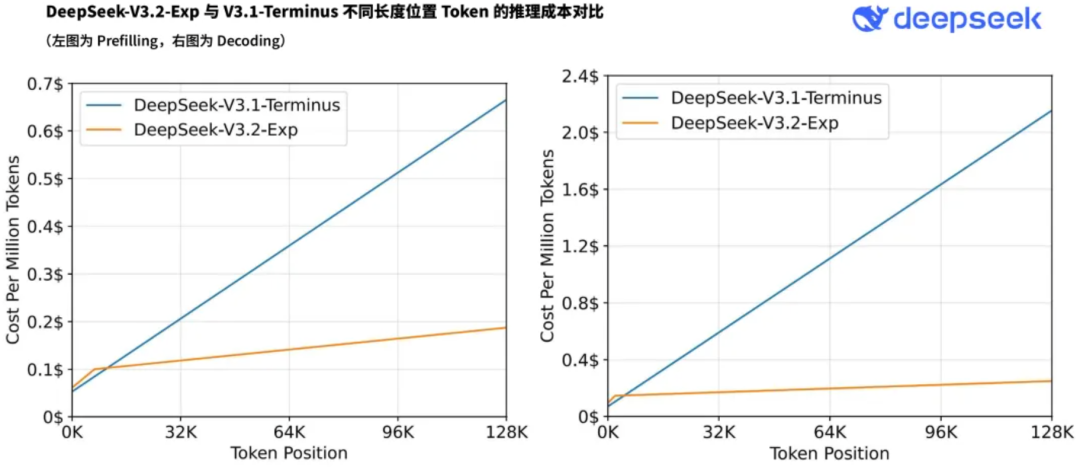
总算更新了!DeepSeek 推出 V3.2-Exp,主打 ‘ 长文本更快更省 ’,同时说 API 成本还能大幅下降。
训练推理大幅提升
引入稀疏注意力,长文本的训练和推理效率更高。
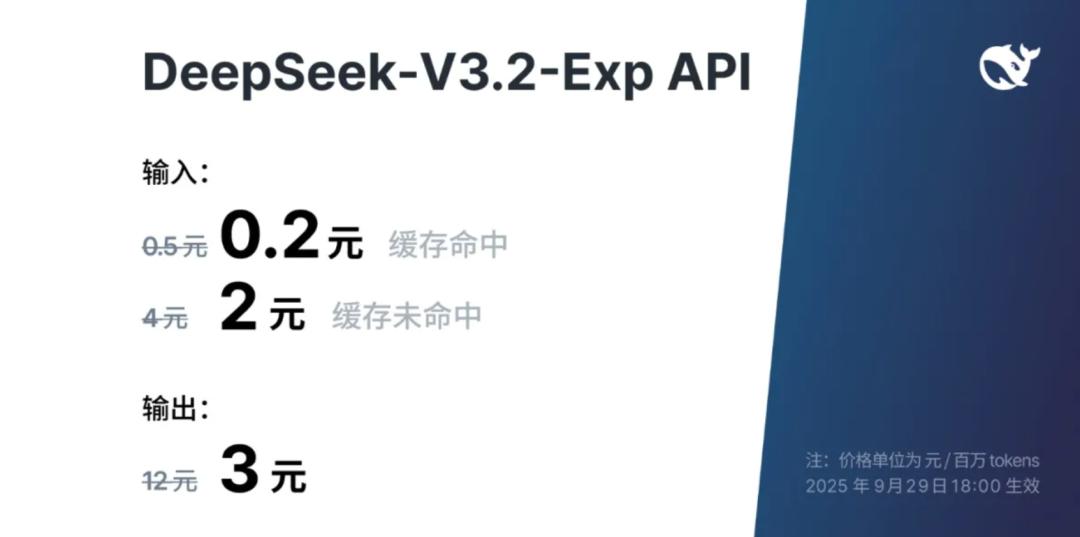
API成本大幅下降
基于新模型的进步,开发者调用 DeepSeek API 的成本将降低 50% 以上。
以上均为官方说法,但宣传归宣传,好不好用还得看实际效果。
今天用一个经典小项目(SaaS 落地页),把 DeepSeek V3.2‑Exp、Kimi‑k2、GLM‑4.5 拉到同一跑道上试试,看看首轮编码到底谁更靠谱。
测试设计
- 场景:SaaS 落地页(前端页面,结构与样式一眼能看懂)
- 模型:DeepSeek V3.2‑Exp / Kimi‑k2 / GLM‑4.5
- 规则:同一提示词,首轮生成,不做二次打磨
- 评价:能跑起来、页面是否完整、样式是否到位
实测编码表现
提示词
生成一个漂亮的 SaaS 落地页,包含主标题、功能卖点、CTA 按钮,样式与排版简洁现代。
打开VSCode,登录cline
设置大模型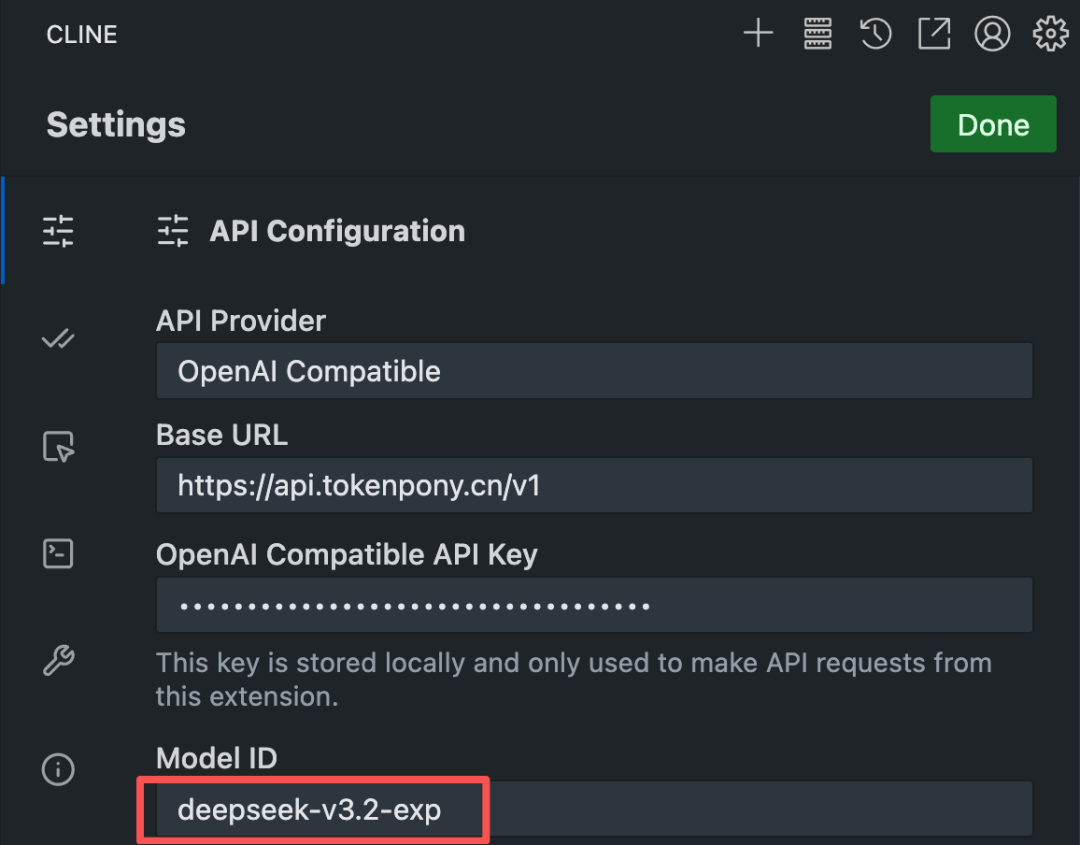
分别用三个模型,生成 SaaS 落地页
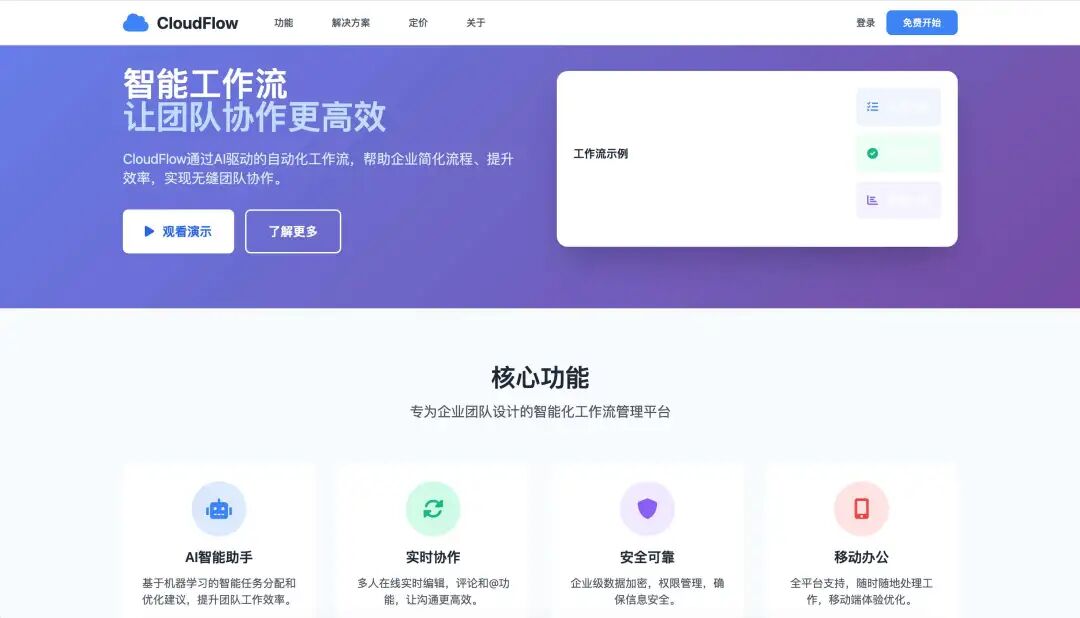
1. Deepseek 生成
###
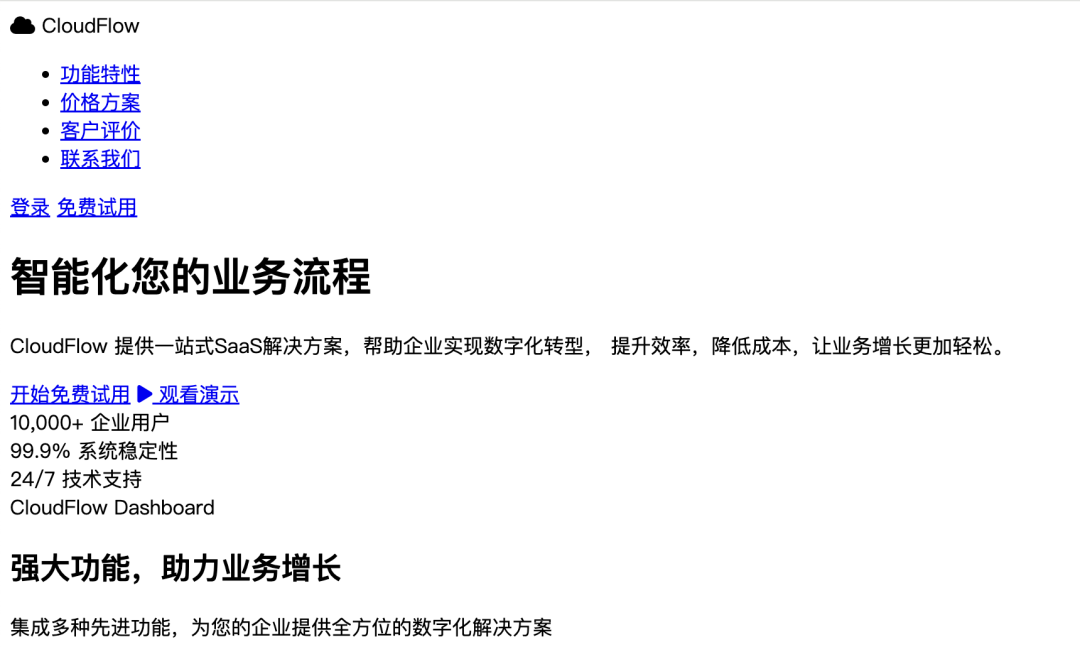
2. kimi 生成
###
3. GLM 生成
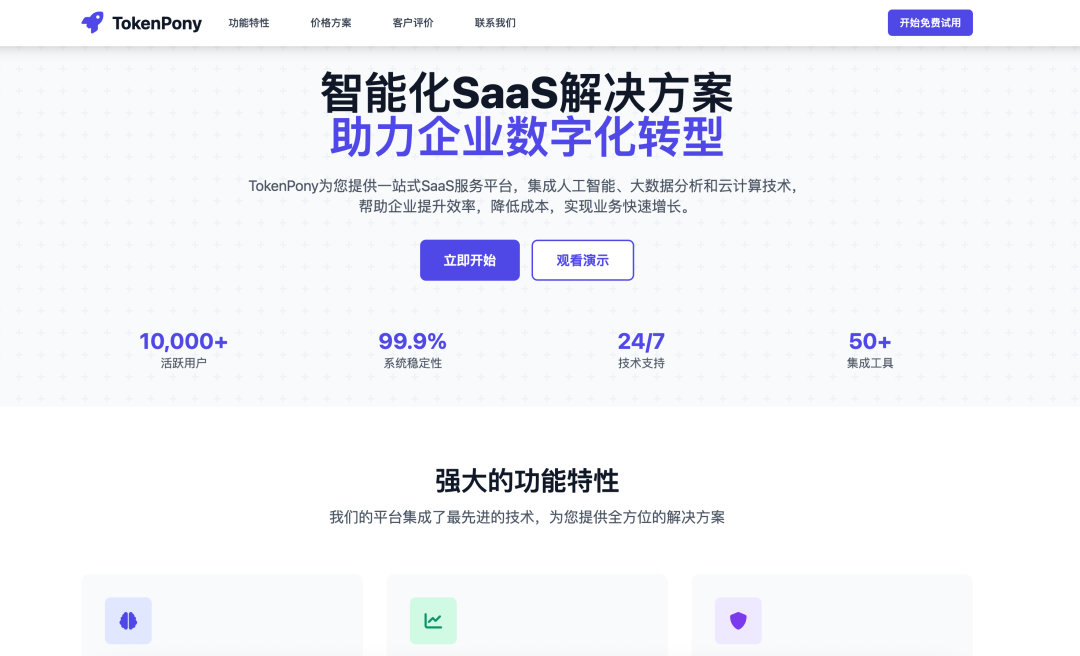
从生成结果来看,DeepSeek能跑,结构清晰,样式不俗,适合直接迭代。GLM能跑,样式稳健,代码易改。Kimi能跑,但样式几乎为空,需要你手动补 CSS样式。
顺手推荐
我工作里要频繁切换模型,单独申请每家 API 确实麻烦。国外可用 OpenRouter;国内可以用 小马算力 ,一个 Key 能切多个模型,省时也省钱。今天的演示,就是在同一环境下切模型来比较首轮体验。
1. 支持主流大模型
| AI厂商 | 大模型 |
|---|---|
| 阿里 | qwen3-32、bqwen3-8b、qwen3-coder-480b、qwen3-next-80b-a3b-instruct、qwen3-vl-235b-a22b-instruct、qwen3-vl-30b-a3b-instruct |
| deepseek | deepseek-v3-0324、deepseek-r1-0528、deepseek-v3.1、deepseek-v3.1-terminus、deepseek-v3.2-exp |
| 智谱 | glm-4.5 |
| Kimi | kimi-k2-instruct-0905 |
| 腾讯 | hunyuan-a13b-instruct |
2. 近期热门活动
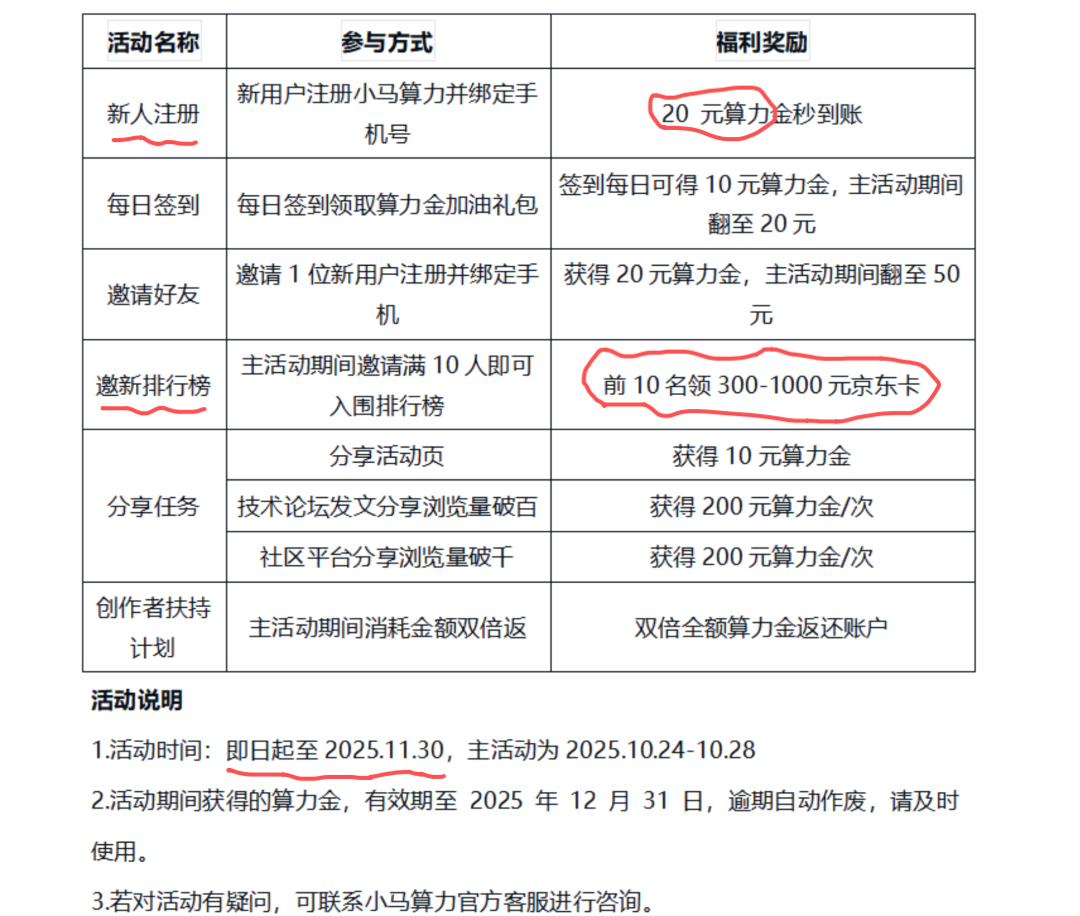
近期 小马算力 推出 《致敬1024程序员节》 活动,优惠力度很大。
- 新用户注册,送20元算力(轻度体验足足够了)
- 邀新排行榜,京东购物卡(能薅真金白银的卡)
3. 快速访问
有需要的朋友们,快去薅一波吧~
https://www.tokenpony.cn/1Jocr
小结一下
想马上能用,就选DeepSeek 或 GLM,结构和样式都在,可直接改。
提交反馈
图文我用同一提示词首测:DeepSeek vs Kimi vs GLM,谁的落地页“一把过”?(送工具包)
评论区
暂无公开评论还没有公开评论。